
vLLM
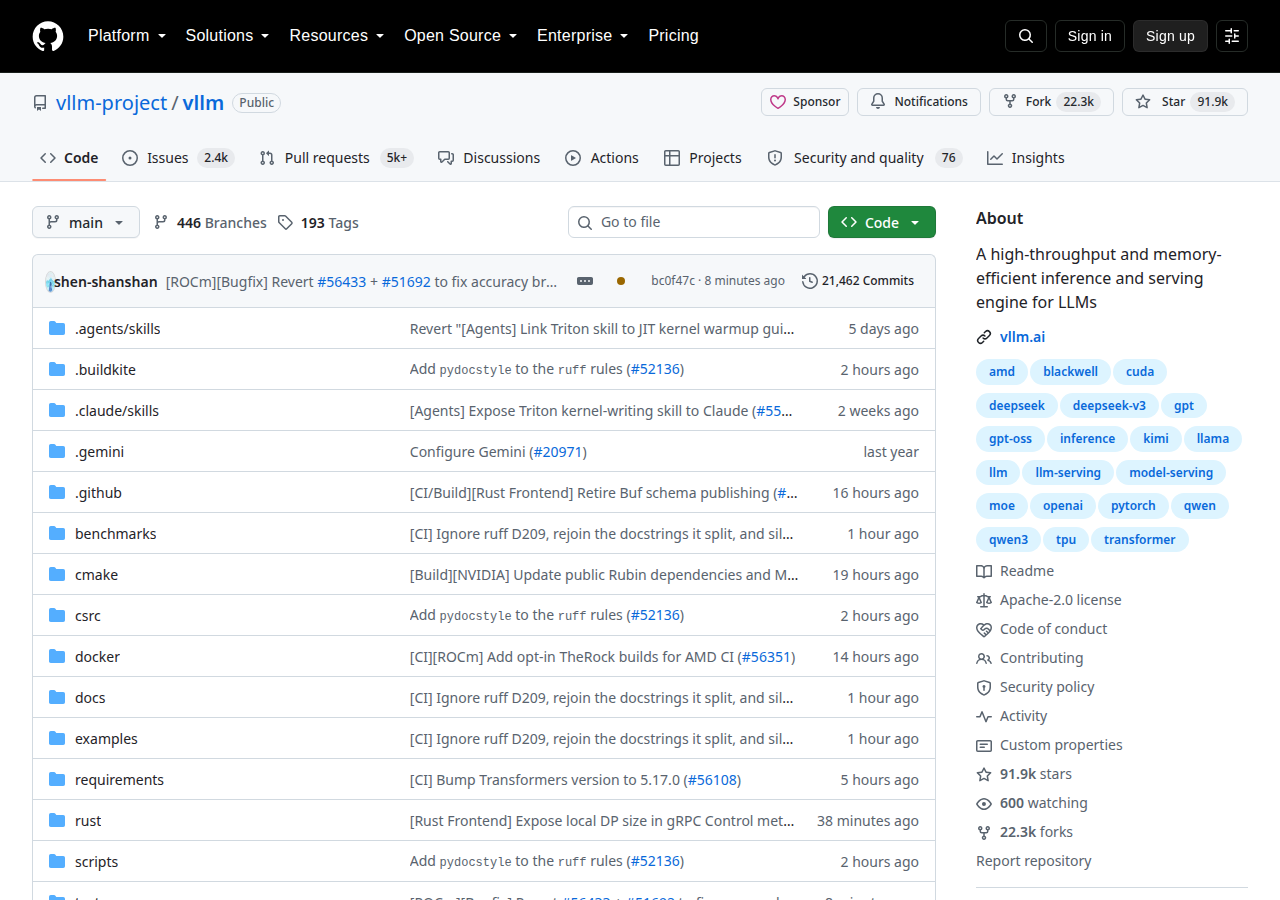
Att köra en språkmodell lokalt är enkelt så länge en person frågar åt gången. Blir det tio samtidiga användare tar minnet slut. vLLM löser det med smartare minneshantering och genom att väva ihop förfrågningar medan de pågår, vilket ger fler svar per grafikkort. Över tvåhundra modelltyper stöds, och tjänsten svarar på samma sätt som OpenAI:s API, så befintlig kod kan ofta peka om utan ändring. Projektet startade på universitetet i Berkeley och underhålls i dag av tusentals bidragsgivare. För ett UF-företag krävs ett rejält grafikkort för att det ska vara meningsfullt. Men bygger ni något med AI där data inte får lämna skolan är det här vägen.
Vad det är
vLLM kör språkmodeller på egen hårdvara och är byggt för att svara många användare samtidigt. Det används när en modell ska ligga bakom en tjänst, inte bara testas av en person i taget. Det krävs ett grafikkort med rejält med minne.
Guider som nämner verktyget
Ingen guide nämner verktyget ännu.
- Driftform
- Server/VPS
- Kategori
- AI och LLM
- Webbplats
- github.com
- Kodrepo
- github.com/vllm-project/vllm